Daily News #2026-09-24
- iPhone Duo 模拟器:测试与优化你的 SwiftUI 应用
- MTFM:美团统一推荐基座大模型在外卖多业务场景的落地实践
- GeoRA:为 RLVR 设计的 LoRA——ACL 2026 杰出论文解析
- MTFM:美团统一推荐基座大模型在外卖多业务场景的落地实践
- 不受控的 Agent,凭什么上生产系统?
- 腾讯 15 年资深后台工程师,转战大模型推理的抉择
- Priorities and principles for effective third party assessments
- What a task costs on Opus 5.5:Claude Code 任务成本深度拆解
- Little Memory 2.0:把 15 年的日记数据从我的服务器迁移到用户手机上
- 502 宇宙超级工程是如何垮掉的:刘怡谈「挑战者号」事故四十周年
🍎 iOS Blog
iPhone Duo 模拟器:测试与优化你的 SwiftUI 应用
来源:SwiftLee
发布时间:2026-09-22 18:14:40
苹果在 Xcode 27.1 首个测试版中内置了 iPhone Duo 模拟器,开发者可以将设备折叠成不同角度并实时观察应用的响应,用于测试和优化 SwiftUI 应用的折叠屏适配。
- iPhone Duo 模拟器随 Xcode 27.1 首个 beta 推出,是首个支持折叠形态交互的 iPhone 模拟器,体验与以往任何模拟器都不同
- 开发者可在模拟器中调整折叠角度,边折叠边查看应用界面变化,无需真机即可提前验证适配效果
- 适合正在为折叠屏 iPhone 做适配的 SwiftUI 开发者
- 原文内容为 RSS 摘要截断,具体的测试与优化步骤未包含在内
📥 Tech News
MTFM:美团统一推荐基座大模型在外卖多业务场景的落地实践
来源:美团 · 技术团队
发布时间:2026-09-22 15:01:37
 美团在 MTGR 基础上推出统一推荐基座大模型 MTFM,首次实现外卖多个主要业务的统一精排模型,各业务订单量提升 2.06%~6.68%,推理成本降低 24%,相关工作已被 KDD 2026 接收。
- 针对规模可扩展性、场景可延展性、架构高效性三大挑战,MTFM 以异构 Tokenizer(H/R/T 三类 Token)与动态掩码实现多场景特征免显式对齐;混合注意力架构(Target:Full=3:1)突破长序列平方复杂度瓶颈,样本吞吐达全 Full Attention 的 2.9 倍。
- 借鉴 LLM 训练实践:深度感知初始化与 Muon 优化器将随机实验 AUC 波动从 0.4pp 降至 0.1pp;User-Level 训练范式让多业务共享长序列计算,配合 Flash-Attention 重构、GLN 算子融合、特征精简等优化保障训推效率。
- 在网络层数、Token 维度、序列长度三个维度验证了稳健的 Scaling 能力;跨场景信息迁移有效缓解小流量业务数据稀疏问题(提升 0.60~0.93pp),为更大规模推荐基座落地打下基础。
GeoRA:为 RLVR 设计的 LoRA——ACL 2026 杰出论文解析
来源:美团 · 技术团队
发布时间:2026-09-22 15:01:37
 美团与北京大学合作的《GeoRA: Geometry-Aware Low-Rank Adaptation for RLVR》获 ACL 2026 杰出论文(全球仅 18 篇),首次面向 RLVR 的优化几何设计低秩适配方法,以 LoRA 级训练成本取得全参微调效果。
- 核心洞察:RLVR 与 SFT 的优化几何存在本质差异——RLVR 更新分散在稀疏子空间且避开预训练权重主方向,为 SFT 设计的 LoRA/PiSSA/MiLoRA 存在几何错位,易导致效果欠优、能力遗忘甚至训练崩溃。
- 方法分三步:用谱先验(稳定性)与欧氏先验(可塑性)双掩码定位 RLVR 偏好的更新区域,经 SVD 压缩为低秩稠密适配器,冻结残差作锚点保证初始化函数不变、平滑冷启动。
- 在 1.5B~32B 的 Qwen/Llama 模型上,数学、医学、代码三类 RLVR 任务稳定优于低秩基线,分布外遗忘显著少于全参微调;可训练参数降低 99.5%,显存降低 28.5%。
- 已落地 AI 骑手招聘 Agent 场景,效果与全参训练相当、较 LoRA 提升约 12%,显存较全参降低 54%;文中还分享随机 SVD 加速初始化、利用函数不变性省去参考模型存储等落地经验。
MTFM:美团统一推荐基座大模型在外卖多业务场景的落地实践
来源:BestBlogs.dev - 精选文章
发布时间:2026-09-22 17:02:06
 美团推出统一推荐基座大模型 MTFM,首次实现外卖多业务场景统一精排:核心业务订单量最高提升超 6%,推理成本降低 24%,并验证了层数、维度与序列长度上的 Scaling Law。
- 架构上采用类 Transformer 骨干与异构 Tokenizer(H-Token/R-Token/T-Token),实现多场景特征免对齐的端到端统一建模,配合动态 Mask 机制防止信息泄露,解决各业务长期独立建模导致的算力与数据无法复用问题。
- 引入 Target:Full=3:1 混合注意力降低长序列计算复杂度,并以 Target Token Scale-Up 缓解目标信息过度压缩,兼顾模型能力与推理效率。
- 训练范式从曝光级(PV)升级为用户级(UV),同一用户多业务曝光共享长序列 Attention 计算,大幅降低训练成本并缓解小流量业务的数据稀疏。
- 工程上通过深度感知初始化与 Muon 优化器解决深层网络训练不稳定,开发 GLN 融合、FA 镜像等定制 Triton Kernel 并精简推理图,将单样本计算量数百倍增长带来的延迟压力降至可控范围。
对推荐系统与大规模模型工程团队有很高的参考价值。
不受控的 Agent,凭什么上生产系统?
来源:InfoQ 推荐
发布时间:2026-09-22 18:58:07
 亚马逊云科技白皮书提出 Agent DLC(智能体开发生命周期)方法论,以“评估”为核心闭环管理 Agent 从定义到持续改进的全流程,回应了“模型只代表能力、外围系统才是生产力”的企业落地难题。
- 背景:Gartner 预测超 40% 的 Agentic AI 项目将在 2027 年底前因风险控制不足被取消,美联航客服机器人误答积分有效期即为例证
- Agent DLC 包含定义、构建、评估、发布、观测、回流六环节,“发布”是门,放行由评估判据决定而非人工拍板
- 评估沿认知、质量、责任、成本、性能五个维度设判据,每条分红线(一票否决)、门禁、观测三档,门槛须在首次评估前冻结
- 裁判模型存在位置偏差、冗长偏差、自我偏好、分辨率过粗四类偏差;用 Correctness 还是 Faithfulness 评估器选择不当会造成全零误判
- 提供四格二分法定位根因、三级归因(会话/轨迹/步骤)指导修复;修复优先级为分数可信性 > 数据质量 > 提示词 > 换模型
- AgentCore 案例显示实际收益:Motorway 错误率从 1/8 降至 1/50,巴西医疗集团 Rede Mater Dei 工具选择准确率提升 38 个百分点
腾讯 15 年资深后台工程师,转战大模型推理的抉择
来源:BestBlogs.dev - 精选文章
发布时间:2026-09-22 18:55:00
 腾讯一位 15 年资深后台工程师分享转型大模型推理工程的心路历程,核心结论是:AI Infra 本质是通用 Infra 的演进延伸,Agent Infra 将成为传统后台开发者最具价值的新战场。
- 转型的核心挑战在于放下职级包袱、回归技术本质——决定价值的是解决问题的实际贡献而非头衔;拥抱 AI 浪潮最好的方式是选择离模型最近的方向。
- 推理工程应建立“从总到分”的分层认知:业务层(SDK、部署)、调度层(分布式并行、KV Cache、Continuous Batch)、算子层(高性能计算单元),以分层架构降低复杂度、让团队聚焦边界。
- AI Infra 并非仅是 GPU 加速,底层仍依赖平台化建设、研效提升与稳定性保障,传统后台工程师在分布式与系统工程上的积累可无缝迁移。
- Agent 带来的长会话调度、状态持久化、长短记忆管理及工具沙箱等问题,正是系统设计能力的用武之地。
适合处于职业转型期或希望布局 AI Infra 方向的资深工程师阅读。
Priorities and principles for effective third party assessments
来源:OpenAI News
发布时间:2026-09-22 08:00:00
OpenAI 发布官方声明,阐述了针对前沿模型及安全防护措施开展第三方安全评估的优先事项与基本原则,核心主张是此类评估应当严格、安全且保持独立。
- 评估对象聚焦于前沿模型与安全防护机制,涉及外部机构对 OpenAI 最先进模型及其保障措施的独立审查;
- 声明强调了三个关键要求:严格、安全、独立,这与当前 AI 行业面临的监管审视和公众信任诉求相呼应;
- 需要注意的是,本次可获取的正文仅为一句概述,未披露具体原则条目、评估流程、参与机构名单或时间表等细节,完整内容需查阅原文链接;
- 适合关注 AI 安全治理、前沿模型监管与第三方审计机制的读者,可作为追踪 OpenAI 安全政策演进的参考线索。
🤖 AI Coding
What a task costs on Opus 5.5:Claude Code 任务成本深度拆解
来源:Claude Blog
发布时间:2026-09-22 08:00:00
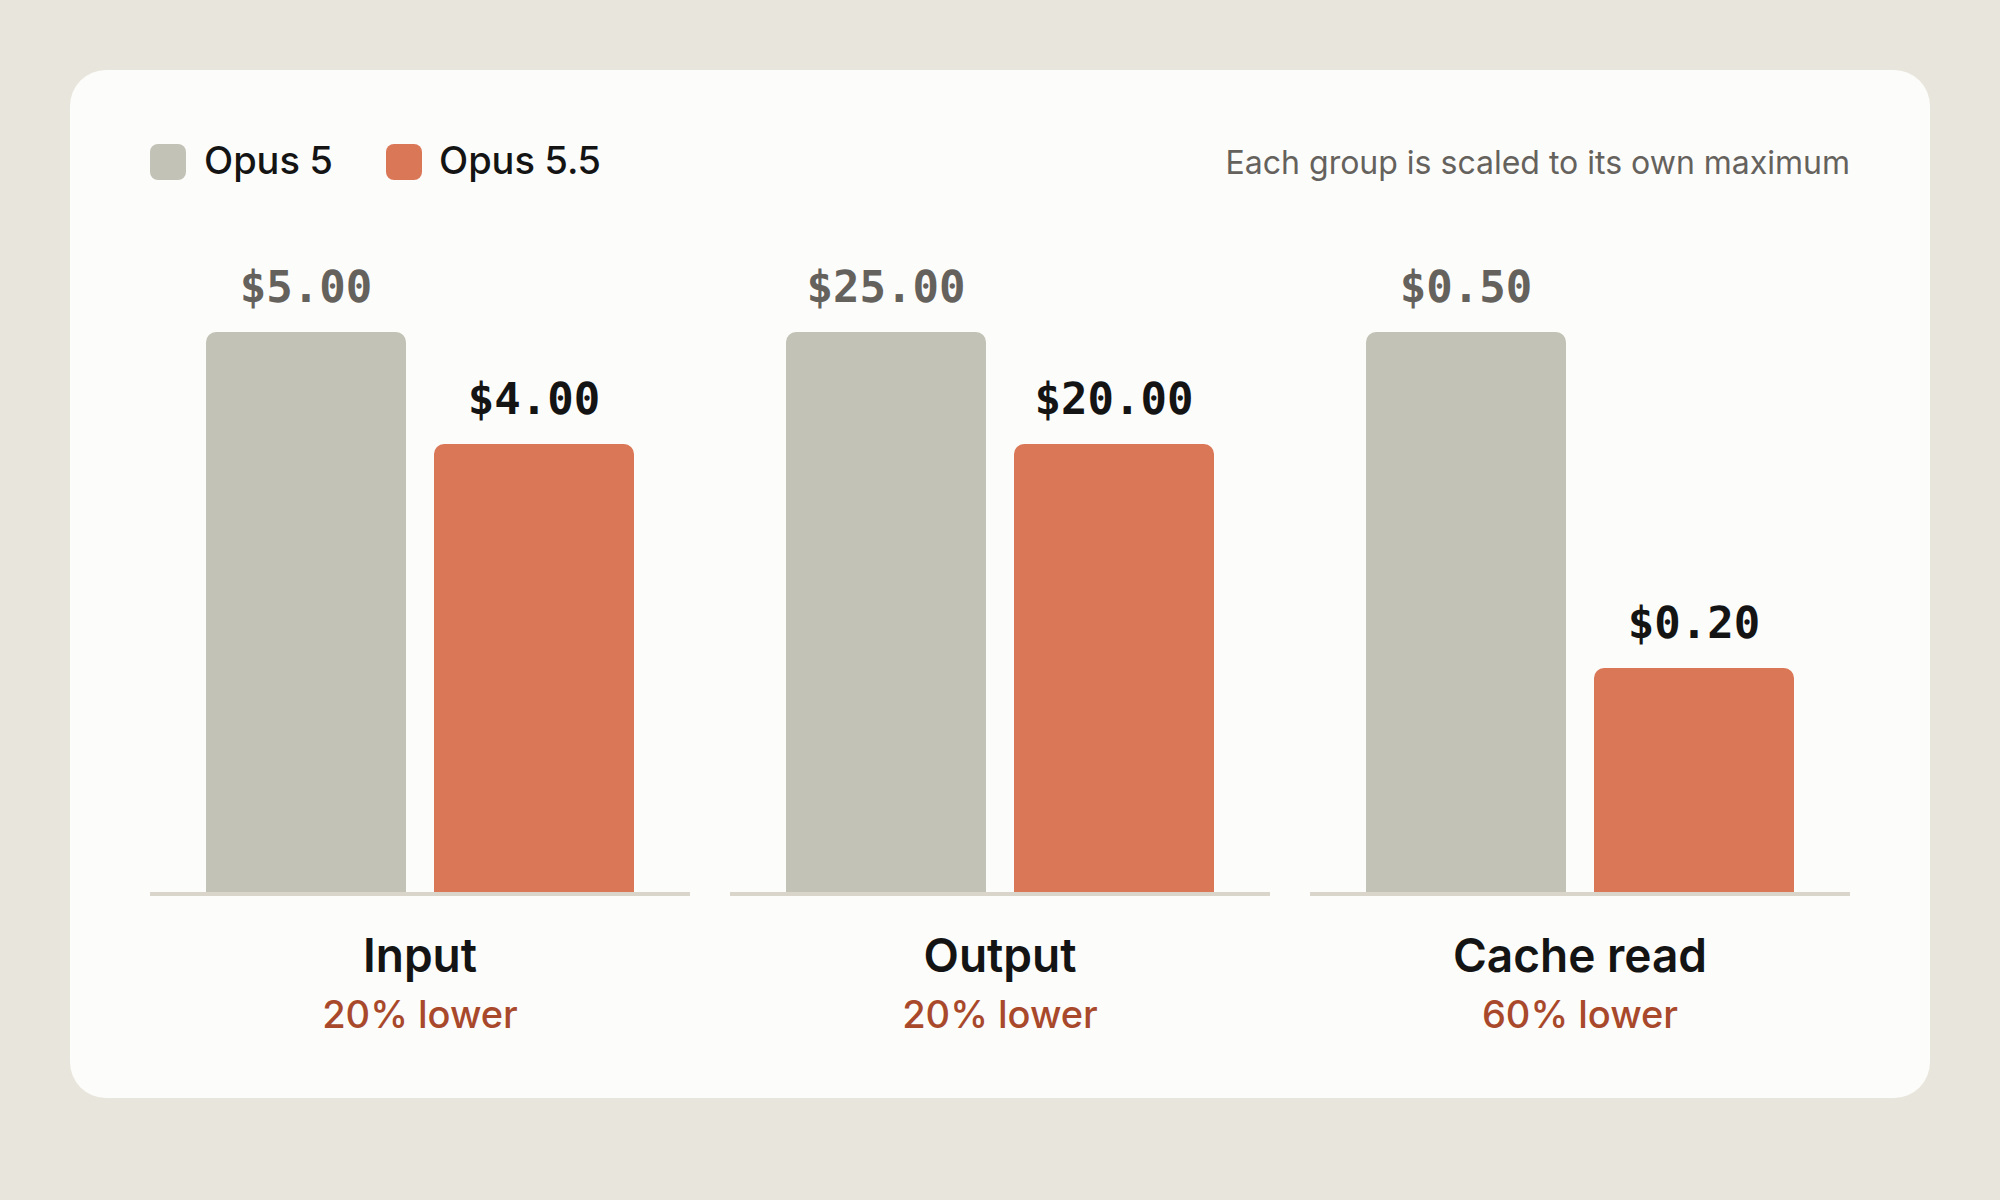 Anthropic 官方拆解了 Claude Code 任务在 Opus 5.5 上的真实成本:相比 Opus 5,输入/输出 token 降价 20%、缓存读取降价 60%,同等 token 用量下会话约省 31%;但任务总成本更多取决于回合数、缓存命中率与思考输出量,而非单价本身。
- 成本由四要素决定:回合数(每回合重发全部对话历史)、缓存读取(按输入价约 1/20 计费)、输出 token(含思考,单价为输入的 5 倍)与所选模型。示例任务在 90% 缓存命中下输入成本约 $1.62,无缓存则高达 $11.20,缓存是影响最大的单一因素。
- 实操建议:用 /usage 查看会话实际用量;优先提升 effort(low/medium/high/xhigh)而非换大模型——high 档约多花 $0.40 即可抵消一次十回合的重试;给模型提供测试、构建等自查手段能更早发现错误、减少回合数。
- 注意事项:修改 effort、thinking 设置或切换模型都会清空对话缓存,下一回合需为整个对话支付缓存写入费,建议先 /compact 或带简短计划重开会话。
- 模型选型:无人监督的长任务、代码库中无先例的问题可切 Fable 5.1($10/M 输入、$50/M 输出);Opus 5.5($4/M 输入、$20/M 输出)延迟更低、更适合交互式工作;Pro/Max/Team 订阅额度在 5.5 上约可多用 25%。
💾 Daily Dev
Little Memory 2.0:把 15 年的日记数据从我的服务器迁移到用户手机上
来源:iOS Development News - Telegram Channel
发布时间:2026-09-23 01:17:18
 Little Memory 2.0 完成全面重写,将运营 15 年的”每日一句”日记应用从开发者自有服务器迁移为 iPhone 本地优先架构,数据通过 iCloud 同步,无需账号即可使用。
- 架构动机:开发者长期对在个人服务器上存储用户日记感到不安(担心突发意外导致服务中断),且日记属极敏感数据,在 AI 能力日益增强的背景下服务器被入侵的风险上升,其坚持从未将数据用于 AI 训练;
- 通过 TestFlight 多轮测试发现并修复了关键问题:Twilio 短信 webhook 乱序导致单日出现重复条目、照片下载后未能正确关联日记的并发 bug,并为测试者提供了照片修复工具,避免了上线后的高昂修复成本;
- 新特性:离线读写、跨设备 iCloud 同步、整 App 重新设计、免费下载(老用户保留 Premium)、Photo Recap 照片回顾及 Dark Mode;桌面端写作需求通过 Drafts 功能(Premium)解决——网页端写草稿,iOS 应用启动时拉取并合并;
- 图表、提醒、连续打卡、Dropbox 备份与导出等功能保留,完成导入后将不再发送邮件提醒。
📻 Podcast
502 宇宙超级工程是如何垮掉的:刘怡谈「挑战者号」事故四十周年
来源:忽左忽右
发布时间:2026-09-22 16:39:24
- 节目梳理了美国宇航事业从冷战高峰到登月热情消退的转变,指出航天飞机项目自诞生起目标即不清晰,军事需求与科研计划混杂,并在预算削减下大量采用铝合金贴隔热瓦、固体燃料发动机等低成本替代方案。
- 工程师关于密封圈低温失灵的警告被层层忽视,公关与进度考量压倒安全底线,最终导致飞机升空73秒后爆炸解体;爆炸后至少三名宇航员曾开启氧气包尝试自救。
- 节目进一步反思NASA的「Go Fever」文化:为何马斯克的SpaceX可以容忍反复失败、快速迭代,而NASA却背负不可失败的公共形象,这种组织文化差异本身就是重要的风险来源,对大型工程组织的管理者尤具借鉴意义。